9 月 18 日下午,由开放原子上海开源促进中心、OpenTenBase 社区、OpenLoong 社区主办,上海市人工智能行业协会、腾讯云架构师技术同盟协办的「开放原子技术沙龙·开源 × AI Meetup 上海站」成功举行。活动以「开源引力场:从数据底座到具身智能」为主题,近百位来自数据库、AI 应用、云计算与机器人领域的开发者、架构师和企业技术负责人及高校师生到场参与交流。
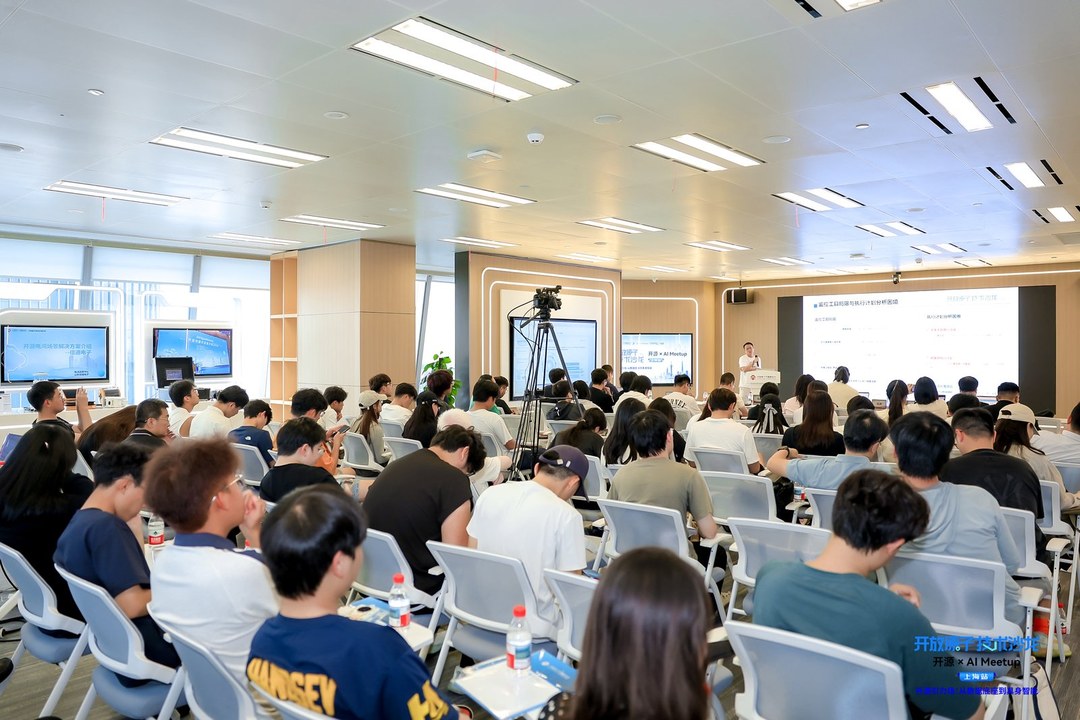
这场沙龙最不一样的地方,是它并不限于单一技术栈:从数据库内核到 AI Agent,从开发范式到认知方式,从数据底座到人形机器人的量产中试,六个议题分别站在开发侧、数据侧、认知侧和产业侧,讲的其实是同一件事的不同切面 —— AI 到底怎么在真实场景里产生价值。
一、沈欣:软件的下一个形态是「智件」
腾讯云 TVP、腾讯云架构师上海同盟理事沈欣以《AI Coding 的实践与思考》开场。
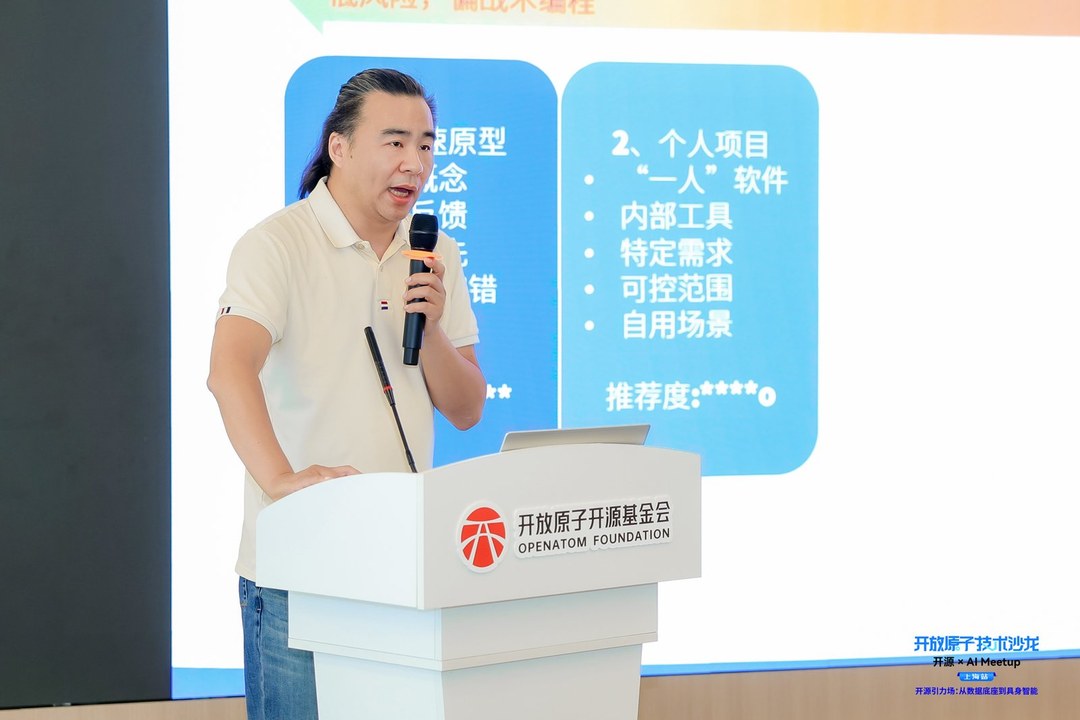
作为有 30 年开发经验的架构师,他先把自己三年来的观点变化摆到台面上:三年前预测「未来三年程序员行业消失」,2025 年初腾讯云架构师同盟形成「AI 编程的未来只剩下架构师」的共识,2026 年 5 月发文追问「普通人能写程序了,他们写出来的是『程序』么」,7 月底又发出「AI Coding 导致系统腐败后的新商机」——这些判断今天被重新审视。
他给出了一份现阶段 AI Coding 的场景风险分级:快速原型、个人项目、重复性代码可用,企业级软件要慎之又慎,生产系统则不推荐。在他看来,「软件的最大敌人是迭代」——屎山代码、性能瓶颈、新 bug、文档混乱、成本失控几乎都来自迭代,而文档里永远只记录了「为什么要这么做」,至于「为什么不那么做」是一个黑盒;即便对 AI,迭代同样会带来上下文容量的限制。落到实践,他给出了自己的一套工程框架取舍:选择无需编译重启、自动测试效率最高的 PHP,在 Docker 中开发以保持一致,追求「意图即结果、没有魔法、一个文件就是一个功能」,去掉各类让 AI 静态分析迷失的元编程技巧,而性能、失效、降级这些全局问题,留给人来做。这套实践已开源(github.com/smarty-kiki/php-vibe-coding-frame)。
分享的后半程指向未来。沈欣认为,传统软件工程百分之百以「过程交付物」为核心,而现在真正被需要的,是以「最终业务成果收益」为核心;对于传统软件知识是旁观者,在 AI 年代知识必须成为软件内置的一部分。软件必然会进化为「智件」——本体论赋能的智件延伸人的记忆与逻辑,TRIZ(发明问题解决理论)赋能的智件则开始延伸人的灵感与直觉。他的收尾是一句改写过的古语:人 +「智件」= 无敌。
二、何敏:把专家经验固化成 Skill,再让 Agent 跑完闭环
腾讯云 TDSQL-PG 数据库架构师何敏的分享题为《TDSQL PG + WorkBuddy 在高难度去 O 交付场景的提效》。
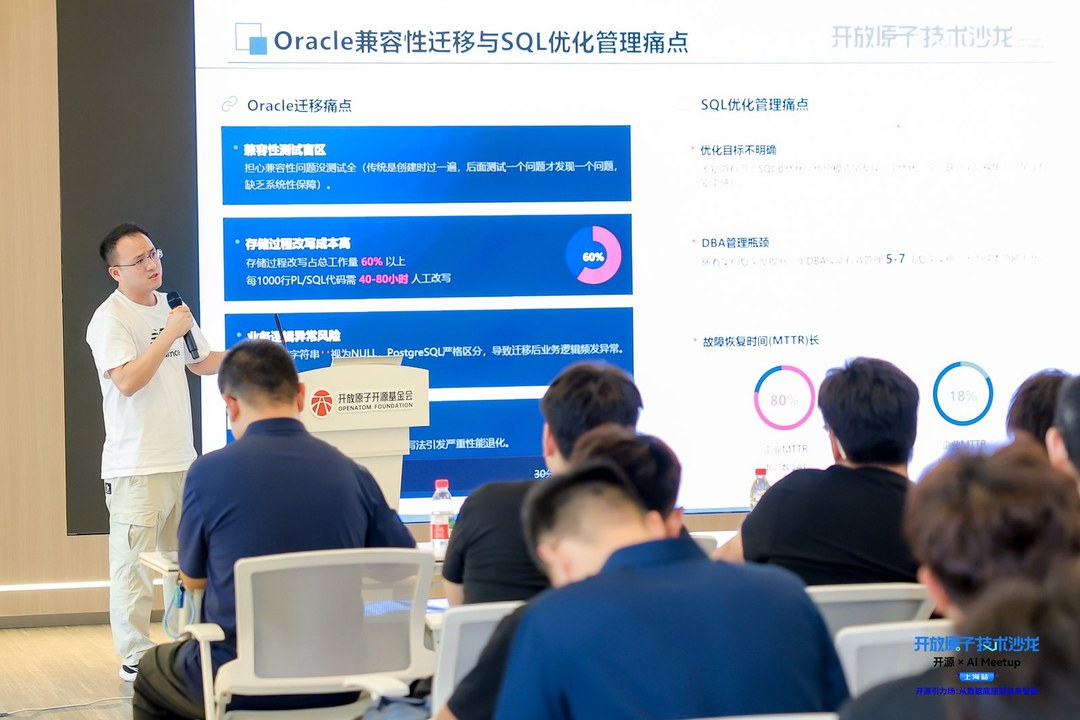
他把传统交付与运维的痛点拆得很具体:一条慢 SQL 从发现诊断到最终执行完成,MTTR 往往长达 1—3 天,其中跨部门沟通占据了总闭环时间的 50% 以上,约 50% 的响应延迟源于开发提交信息不全;pg_stat_statements 参数脱敏看不到具体值、平均值掩盖长尾异常、存储过程近乎黑盒;而在去 O 迁移里,存储过程改写占到总工作量的 60% 以上,每 1000 行 PL/SQL 代码需要 40—80 小时人工改写,并且常被 Oracle 空字符串视为 NULL、分布式下「游标循环 + 单条 DML」的性能退化等问题反复绊倒。
他的解法是一条三层递进的路线。第一步是把历史经验「喂」成结构化知识:以《SQL 性能调优实践》方法论、25 篇分布式改造问题总结、10 余份专项分析报告和 3 套 SQL/执行计划样本为素材,固化为 Skill「tdsql-pg-sql-optimization」,包含 15 个知识模块、34 个带真实加速比的实战案例,覆盖分布式核心机制、执行计划固化、索引与存储、诊断监控、迁移兼容五大类,并有九维对比的验证框架——每次优化验证通过,案例与规则自动回写知识库,项目做得越多 Skill 越准,案例库中的最高加速比达到 32,637 倍。第二步是提前发现问题:19 条静态检查项按 P0/P1/P2 分级,不连数据库、不需要执行计划即可「体检」,并已具备 CI/CD 就绪的退出码机制;针对 Oracle 兼容性,则由 compat-guide 定判据、code-scanner 出清单、code-migrator 在范围、规则、安全「三道电子围栏」内受控改造。他分享的实战案例中,一条集中式复杂 SQL 经三轮优化从 60 秒降到 480 毫秒,零代码改动、仅靠 5 条 CREATE INDEX 换来 125 倍提升。
第三步是完成闭环。何敏介绍了 PG_DBAgent:它靠的是知识库、Skills 与 MCP 工具三层能力的协作——知识库告诉 Agent「日志字段是什么含义」,Skills 告诉它「该按什么 SOP 排查」,MCP 让它真正能把手伸进日志平台去检索,LLM 只是中间负责串联的决策大脑。目前它已支持 SQL 优化、SQL 沙箱验证、Oracle 语义对比、实时与历史慢 SQL 定位、报错检索、负载分析等十余个场景(所有写 SQL 均强制 BEGIN…ROLLBACK),最终把测试提单到自动定位的流程串起来,省掉开发定位、数据库定位、参数核对、历史 SQL 回溯这四个最耗时的排查环节。
三、马洋:我们在驯化 AI?其实 AI 在驯化我们
北京富通东方科技有限公司生态合作中心总经理兼华东区总经理、腾讯云架构师上海同盟成员马洋带来了一场不谈技术细节、却可能最影响未来三年工作方式的分享。
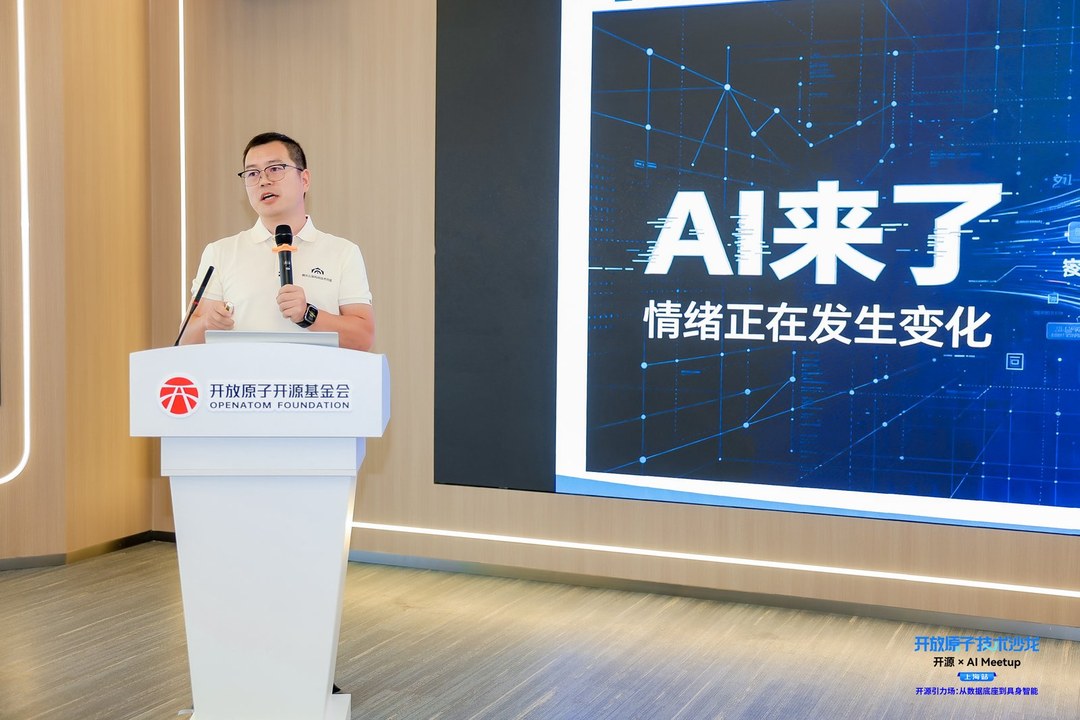
他从「面对 AI,我们内心是多重情绪的混合体」切入,把 AI 的发展周期从 1950 年代的符号主义、1980 年代的专家系统、2010 年代的统计学习、2012 年后的深度学习一路讲到 2022 年至今的大模型浪潮,并对比了辨别式 AI 与生成式 AI 的差异,梳理大模型应用的三个阶段与应用工具的成熟。
在「还要不要大量用 AI」这个问题上,他的回答直接而明确:应该用,因为势不可挡。真正要做的,是在用 AI 提效的同时,革自己认知的命、革工作传统思维的命,建立起「AI 高一尺,人类高一丈」的关系。分享以「人机双向共生」作结:AI 与人类,鱼水相依,共生共进——我们一起缔造 AI 文明。
四、于献琦:公共中试平台,打通人形机器人量产「最后一公里」
国地中心中试服务平台负责人、OpenLoong 开源社区整机与系统 SIG Committer 于献琦,把现场从「数字世界」带到了「物理世界」。
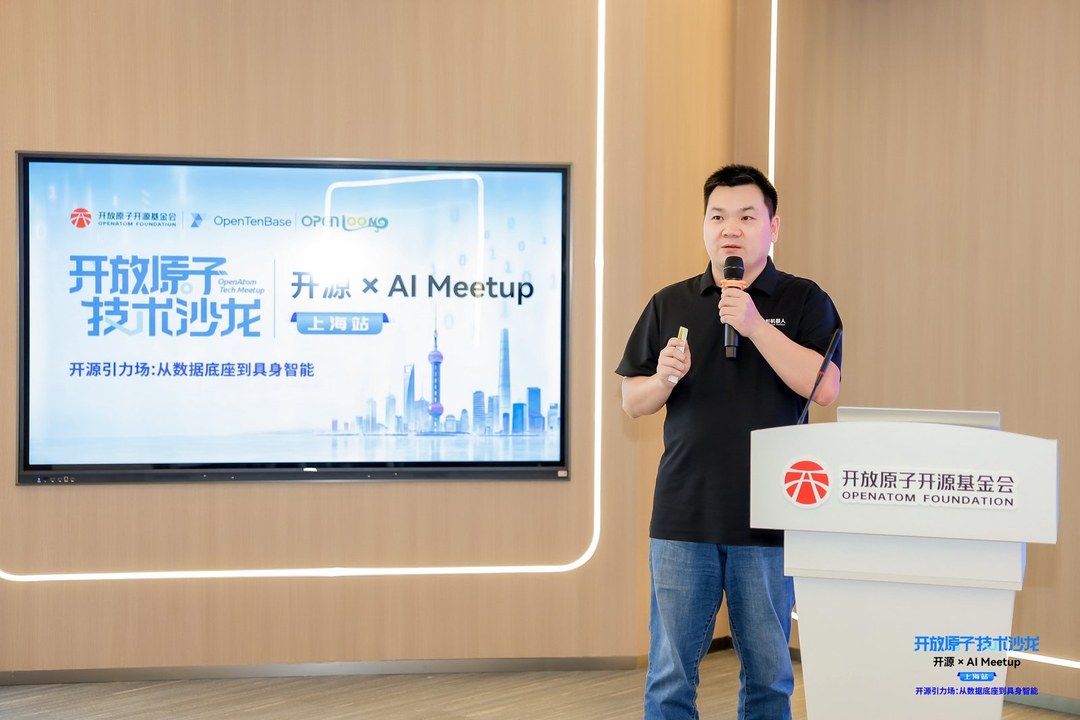
据演讲介绍,上海市人形机器人中试服务平台 2025 年 12 月在上海市经信委立项,2026 年 7 月 18 日正式发布,已获上海市中试平台(示范)与工信部储备中试平台,正在申报工信部重点中试平台。
在服务模式上,平台以「3+2」运营覆盖产品从 0—1 原型打样到 1—100 小批量试制的全过程,配套供应链对接、成果对接、企业孵化与政策金融服务;已落地的真实案例包括灵巧手的适配开发与全性能测试、轮臂机器人的来图加工与装调测试、仿人机器人 100+ 台的放量稳定性验证,以及运控算法的真机平台验证。
围绕开源生态,平台正与 OpenLoong 开源社区、海智在线供应链平台、上海市人形机器人中试联盟协同,并获得中国人寿中试保险、浦发银行等金融服务与政府创新券、首台套、中试卷等政策支持,帮助更多中小团队跨过量产门槛。
五、范自豪:三项优化,把全局一致性读的性能损耗压下来
腾讯云数据库工程师范自豪分享了《TDSQL-C 一致性读性能优化落地实践》。
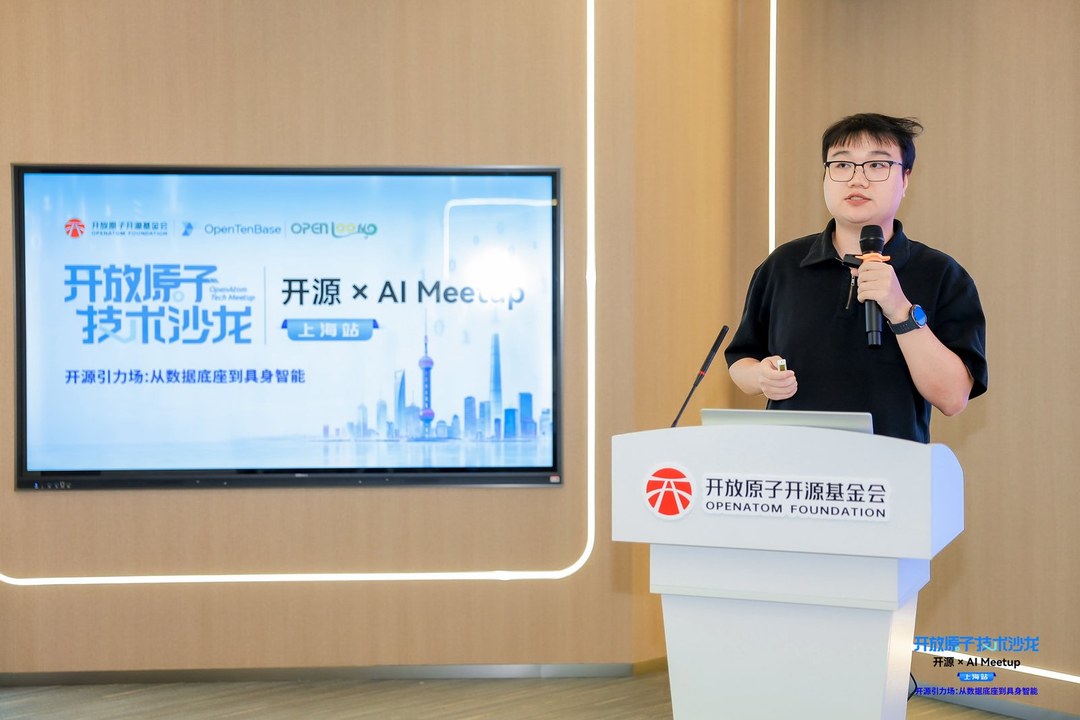
他先介绍了已捐赠至 OpenTenBase 社区的 TXSQL 企业级 MySQL 内核——腾讯数据库团队深度定制的 MySQL 分支,统一支撑 CDB、TDSQL-C 与分布式 TDSQL,运营规模达 200 万+ CPU 核、100PB+ 存储、40 万+ 实例,累计 100+ 自研特性、100+ 回馈社区的 bugfix 与 25+ 回馈社区的功能。
云原生一写多读架构下,只读副本长期面临一致性与性能的权衡:最终一致性读性能最高但数据滞后,全局一致性读数据实时但开销大。范自豪指出传统实现的两类缺陷——一是每个读请求都要向主节点取位点,1024 并发点查 80 万 QPS 时,一次简单的取位点操作就消耗 RW 近 60% 的 CPU,加只读副本反而拖慢主库;二是「等拿到 lsn、等 apply 推进、等 readview 刷新」三段等待完全串行,快照按 5ms 周期刷新、平均还要再等 2.5ms,低并发下性能损耗高达 70%。
对应地,团队给出三项彼此独立、收益可叠加的技术:全链路日志并行——并行 Parse 流水线、并行 Apply 按页分发、用户线程发现依赖页面未回放到位时自行回放,使 RO 复制延迟降至 300—600 微秒;读穿透——不再等全局回放进度,只判定自己要读的那一个页面有无待回放修改,并把可见性判定改为基于 SCN 直接取本次读的 read lsn,省掉平均 2.5ms 的快照刷新等待,绝大多数请求零等待;Get-LSN Offload——线程池结队复用一次 fetch 结果(97%+ 请求零开销)、History Ring 二分查找「刚好够用」的最小 lsn、按事务状态在 RR/RC 下取不同的 lsn 语义,使主库侧 CPU 占用降到 5% 以下。最终,混合读写吞吐提升最高接近 3 倍(8—1024 并发全区间提升 +53%—+294%),点查场景下 1024 并发峰值 QPS 达到 137 万以上、相比优化前提升逾 50%,并达到最终一致性性能的 90%。分享之后,他还带现场开发者走了一遍 TXSQL 的开源贡献流程。
六、陈磊:让训练不再「等数据」
灵初智能算法应用经理陈磊以《PsiBot 具身智能的数据与训练基础设施》压轴。
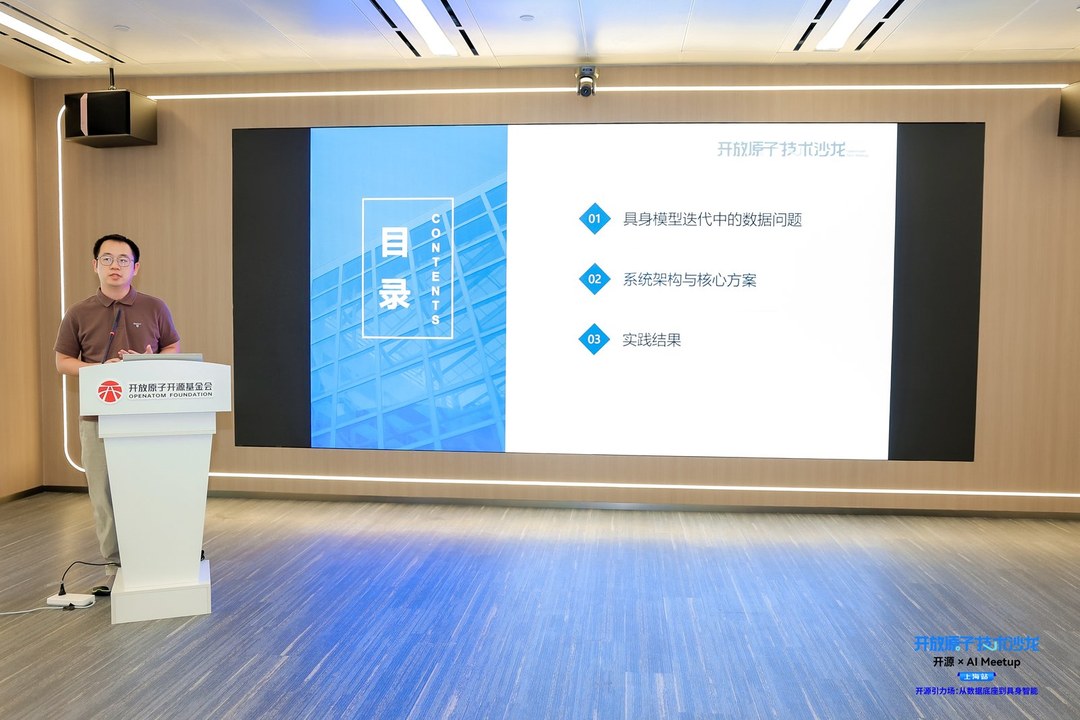
他的核心判断是:具身模型的一次有效实验,远不止一次模型训练——启动之前,处理与准备拖长了等待;训练之中,输入供给限制了计算;而数据持续变化,又让结果难以归因。具体到负载特征,具身训练往往是「数据输入很重、模型计算较轻」,多视角、连续时序与多模态叠加之下,GPU 常常在等数据。
为此,PsiBot 搭了一条从原始记录、处理产物、标准化数据到实验数据和训练输入的完整链路:底层以 COS/S3、LakeFS、GooseFS、CFS、MemCache 作为数据基础层,中间由 Ray、Inference Server 与 Kubernetes 提供可复用的公共能力;数据处理流程被抽象成计算任务、远程服务、处理节点、质检节点四类统一语义,支持算法迭代时的「受控回刷」——沿依赖定位变化,只重建受影响的下游、已有成果继续复用。在实验侧,基础数据、片段索引(Clip)与模型特征被彻底分离:换切片算法只重生成索引,换语言编码器只重算特征,局部变化不再放大为整套重复准备。为了让供给追上算力,团队在样本配比、节点与进程分配、读取顺序三个层面分别做决策,并用 L1—L4 多级缓存、节点亲和性采样与局部连续读取最大化缓存命中。
实测结果显示:处理流程中沉淀数万条数据,帧引用次数与唯一基础帧数之比约 2.24 倍(约 695 万次引用 / 约 310 万帧),基于已就绪数据可在分钟级拉起训练,跨实验持续复用;训练稳态 data_wait 控制在 10 毫秒以内。更重要的是闭环本身——场景问题驱动数据圈选与补充,回流数据进入已有链路快速验证,改进效果与具体场景关联后可持续检验。
从一张数据表的一致性读,到一条机器人产线上的样机试制;从一段 SQL 的执行计划,到一个具身模型的训练输入。四个小时里,六位讲者把「AI 怎么真正落地」这件难事拆成了六个可以动手的地方。技术分享之外,更长的交流发生在茶歇和散场后的走廊里——这大概也是技术沙龙最不可替代的部分。
感谢开放原子上海开源促进中心、OpenLoong 社区、上海市人工智能行业协会与腾讯云架构师技术同盟的支持,感谢每一位到场的开发者。我们下一站见。
OpenAtom OpenTenBase 社区
开源分布式数据库 · 欢迎 Star 与共建