三场演讲、一场圆桌,把“AI 时代怎么做项目”拆成了底座、方法、判断力三层。
一、60 人的小班课:把 AI 讲成可以照着做的步骤
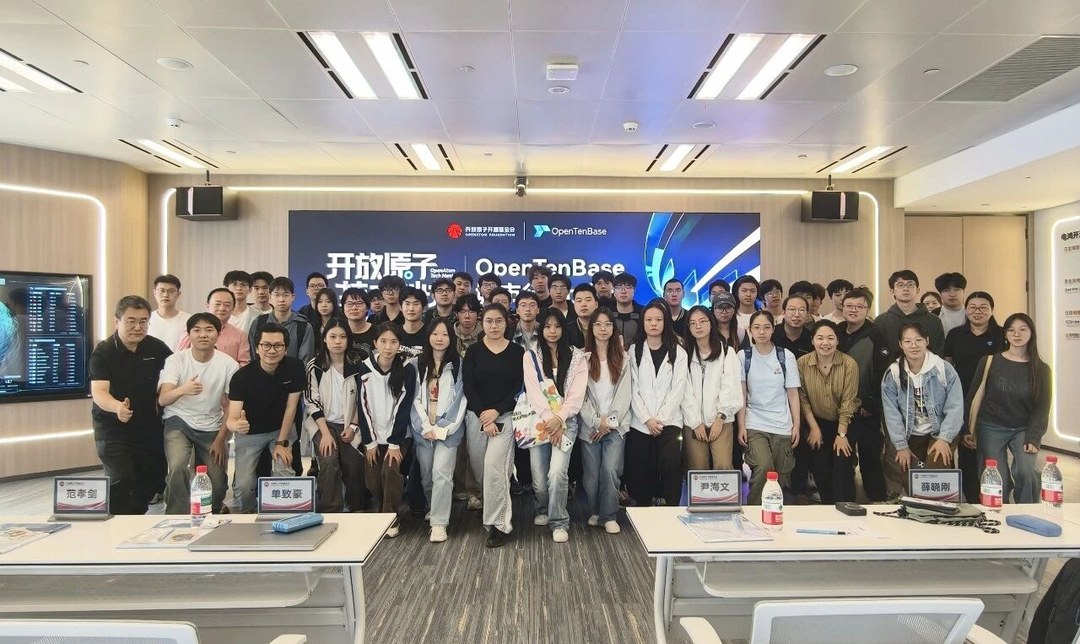
10 月 16 日上午,开放原子技术沙龙 · OpenTenBase Workshop 在开放原子上海开源促进中心开讲。与常规的城市行不同,这一场是限额 60 人的小班 Workshop,听众主体是上海杉达学院正在上《工程技术与创新实践》课程的同学。
三场演讲分别由腾讯云数据库研发总监、OpenTenBase 技术委员会副主席范孝剑,「川序」AI Agent 管理平台创始人尹海文,OpenTenBase ACE 专家委员会主席薛晓刚带来;圆桌环节由 OpenTenBase 社区秘书长单致豪与尹海文、薛晓刚三位专家一同回答同学们的提问。
二、四个关键技术观察
把三位讲者的内容放在一起看,能看到四条彼此咬合的技术判断。
观察一:数据库的服务对象,第一次从人变成了 Agent
过去人用数据库,是写一条 SQL,目标明确;Agent 用数据库,是先加载会话状态,再按需检索知识、查询业务数据、记录执行结果,链路长、目标还会漂移。由此带来三个变化:数据消费者从工程师、BI 和应用系统变成 Agent 与自主工作流;数据结构从结构化为主变成文档、图片、向量、图关系并存;数据库的角色从“事实记录系统”变成“智能体执行的基础设施”。
观察二:Agent 落地生产的瓶颈,不在模型,在工程
范孝剑把它概括为三句话:“这个问题的背景,我上次说过了”(记忆缺失)、“为了早高峰那 20 分钟,全天按峰值付费”(弹性不足)、“想改,但不敢在生产上验证”(迭代受阻)。模型能力之外,记忆、弹性、迭代这三道工程坎,决定了 Agent 能不能从演示走到生产。
观察三:AI Coding 的瓶颈,不在“生成”,在“改得动”
尹海文的开场问了三个问题:下个月让你加一个功能,你还改得动吗?答辩时老师问“这段为什么这么写”,你答得上来吗?出了 bug,你能找到是哪一次改动引入的吗?AI 是放大器——放大速度,也放大混乱。缺的不是模型能力,是规格、验收和历史。
观察四:AI 落不了地,卡在数据孤岛与数据治理
薛晓刚的判断最不客气:当前企业的数据散在向量库、时序库、关系库、文档库里,彼此整合不了,AI 就无从训练和应用。“绝大多数企业 AI 没能落地盈利,核心就是数据整合没做好。”而多模融合、数据建模这类活,正是数据库从业者最硬的护城河。
三、观点输出汇总
范孝剑|腾讯云数据库研发总监、OpenTenBase 社区技术委员会副主席
· “数据库的服务对象,第一次从人变成了 Agent。”
· “模型决定了 AI Agent 的下限,而数据底座决定了 AI Agent 的上限。”
· AI 时代企业和个人的差异不再是“谁更懂算法”,而是谁沉淀了更厚的记忆;建议每个人找一个顺手的 AI 工具,长期把笔记、想法、判断沉进去。
· 让 AI 管数据库,先解决“敢不敢”:只读可放开,高危设禁令,数据留在用户 VPC 内,决策与执行全程留痕。
尹海文|「川序」AI Agent 管理平台创始人、OpenTenBase ACE
· “这些问题的答案,不在 AI 的能力里,在做法里。”
· 大模型的本质是下一个词预测器,它没有“理解”的开关,是超大规模的续写,不是懂你项目的工程师。
· “重要约定不能只活在对话里,要落进项目文件。”
· 规格驱动开发的四层结构:需求 → 设计 → 任务 → 实现,越往上改越便宜;“写得好的标准:AI 不需要猜,你不需要返工。”
· “提交密度 = 恢复点密度”“总结是它写的,diff 是它做的。”
薛晓刚|腾讯云架构师同盟上海理事、OpenTenBase ACE 专家委员会主席
· AI 离不开数据,数据都存在数据库里,所以数据库从业者是离 AI 最近的人。
· 行业预测到 2027 年,80% 的 NoSQL 能力会集成进关系数据库,这个趋势正在逐步兑现。
· 企业要的不是“服务器 CPU 满了”,而是哪个业务仓库、哪段代码、哪个开发、因为什么业务操作导致的问题。
· “AI 能抄成功案例,因为它抄的都是成功的;它没抄过那些失败的,也抄不了失败的。”
单致豪|OpenTenBase 社区秘书长
· 参加黑客松时发现,很多纯靠 AI 搭项目的开发者,连 IP 地址组成这种基础常识都不懂,排查问题完全不会。“基本功还是必须要学。”
· OpenTenBase 是开放原子开源基金会大力支持的开源数据库项目之一,当前重点关注 AI 智能体开源生态;欢迎高校作为学术机构加入合作。
· 学习氛围很重要:加入校园学习社团、用考证给自己设 deadline、参加黑客松拿 24 到 48 小时的短周期训练。
四、圆桌上的三个共识
“只有自己基础好,才能判断 AI 做得对不对。你要比 AI 懂的多,才能对 AI 说不。”——薛晓刚
第一,基础功不能丢。 C 语言、数据库原理、操作系统这些课,不是为了让你手写快排,而是为了让你在 AI 出错时能看出来。大学保留这些基础课,是有道理的。
第二,交流能力比写代码更重要。 FDE 模式的核心不是快速出 demo,而是前期把真实需求拿回来。
第三,人工审核是最后一道防线。 AI 生成的内容依然需要人来把关。很多技能在贬值,但思考能力是别人替代不了的。
现场还有一位跨专业考研的同学提问“怎么快速适应”。尹海文讲了自己的经历:本科园林设计,偏文科,后来做了十多年数据库,核心是主动学习——这个时代,可以用 AI 帮你筛行业新闻、遇到不懂就追问它,但不能等着学校教。
五、不是结束
分享之外,交流同样热烈。现场同学提问不断,与嘉宾围着真实问题反复对谈,在一次次回应中解开对未来的困惑。
三场演讲为课程实践任务做了铺垫,圆桌为大家校准了方向;开源贡献的实践路径,也被留在了现场。期待更多同学借力 AI,把想法做成作品,把自己送到更远的地方。
OpenAtom OpenTenBase 社区
开源分布式数据库 · 欢迎 Star 与共建