2026 年 10 月 16 日下午,开放原子技术沙龙 · OpenTenBase 城市行上海站在上海龙之梦大酒店举行。本次活动由 OpenTenBase 社区、开放原子上海开源促进中心与腾讯云联合主办,吸引了来自金融、运营商与互联网一线的 DBA、架构师与 AI 应用开发者到场。
三个小时里,五场主题分享围绕数据库底座演进、AI 商业落地、软硬件性能优化、智能诊断与智能体治理展开,共同探讨一个问题:当 AI 智能体(Agent)进入实际业务,数据基础设施与工程体系需要做好哪些准备?
活动由 OpenTenBase 社区执行总监臧秀涛主持开场。他向到场开发者介绍了 OpenTenBase 社区近期的整体进展,涵盖社区治理机制的完善、版本迭代的节奏,以及在更多行业场景中落地的实践情况。在他看来,一个开源项目的成长,离不开每一位使用者的实际投入——企业用户的一条生产反馈、开发者提交的一行代码或一个 Issue,都是在为这个项目添砖加瓦。
他也在开场中表达了期待:希望有更多企业和开发者加入到 OpenTenBase 社区中来,一起参与共建、共享成果。
面向 Agent 的数据库底座演进
腾讯云数据库研发总监、OpenTenBase 社区技术委员会副主席范孝剑以《AI Agent 时代的数据库底座演进实践》率先开讲。
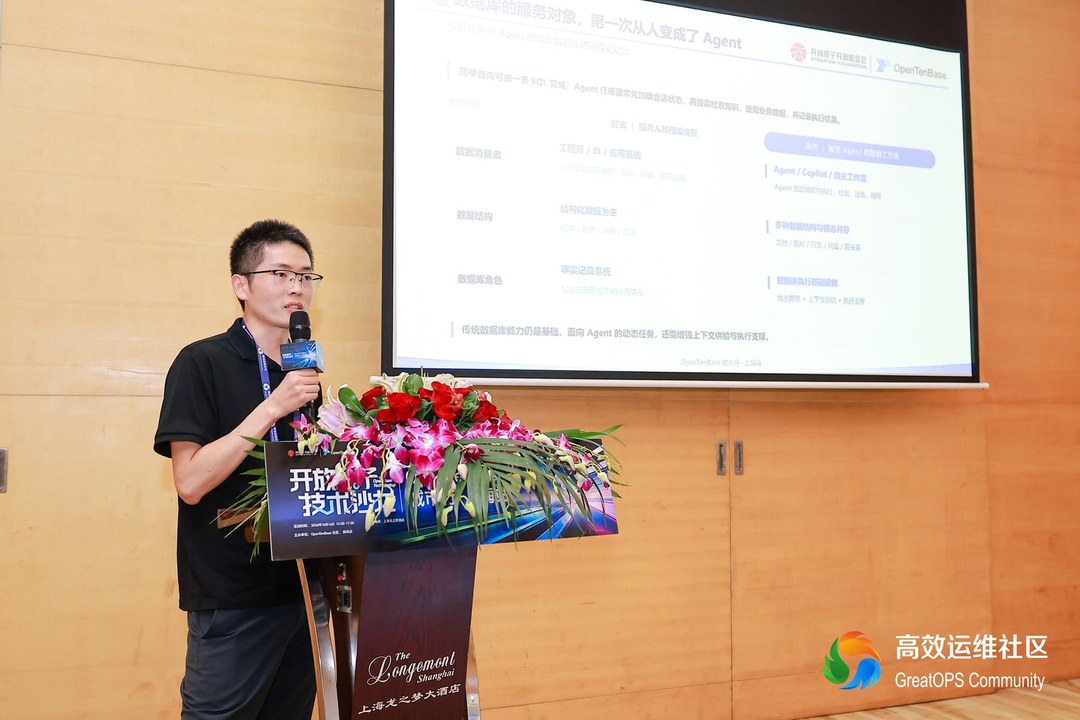
范孝剑结合腾讯云数据库产品与服务的实践,介绍了数据库服务对象与访问模式的变化。传统应用主要通过预设流程读写数据,Agent 则需要在任务执行中加载会话状态、检索知识、查询业务数据并记录结果。数据库除了保存业务事实,还需要为动态任务提供上下文、状态管理与执行支撑。
他将 Agent 从演示走向生产面临的工程障碍归纳为三类:会话状态未持久化、历史经验难以复用带来的记忆缺失;多 Agent 并发和脉冲式流量带来的弹性压力;缺少低成本分支、克隆与恢复手段带来的迭代困难。这些问题需要模型能力、数据库能力与应用机制共同解决。
围绕这些需求,他提出四个演进方向:以 Serverless 和数据库分支支持按需供给资源、隔离验证与低成本试错;以关系、JSON、全文、向量与图等能力的协同,减少跨库同步与应用拼接;通过多层记忆体系,让经验在授权范围内跨会话复用;将权限、审计、审批和恢复机制融入智能运维,实现受控自治。作为数据库底座演进的应用实践,CloudBase PG 以 PostgreSQL 为核心,整合身份认证、云函数、云存储及应用托管,将单一数据库服务延伸为支撑 Agent 应用开发与交付的一体化 BaaS 后端。开发者通过自然语言描述需求,由 Agent 辅助生成应用、配置后端,并在完成验证后发布。据介绍,CloudBase 每日支撑 Agent 创建上万个数据库,表明在 Vibe Coding 场景下,底座不仅需要可靠地存储和访问数据,还需具备按需供给数据库、协同后端服务的能力,以适应应用快速生成与持续迭代的需求。
酒店业务现场的 AI 落地实践
上海感物知行科技有限公司创始人王巍巍带来《前台阿姨沉默了十分钟之后:一家 AI 公司用 FDE 模式落地的真实记录》,从酒店业务现场讲述 FDE 模式的落地实践。他用一家拥有 90 间客房、年净利润不足 20 万元的单体酒店,说明客户对投入产出的敏感:每月 1500 元的软件订阅费都需要反复衡量,AI 产品更必须证明自身价值。随后,他结合另一家拥有 80 间客房的经济型连锁酒店展开案例分析:淡季出租率降至 50%,平均房价三年未变,OTA 渠道订单占比达到 75%,经营改善迫在眉睫。
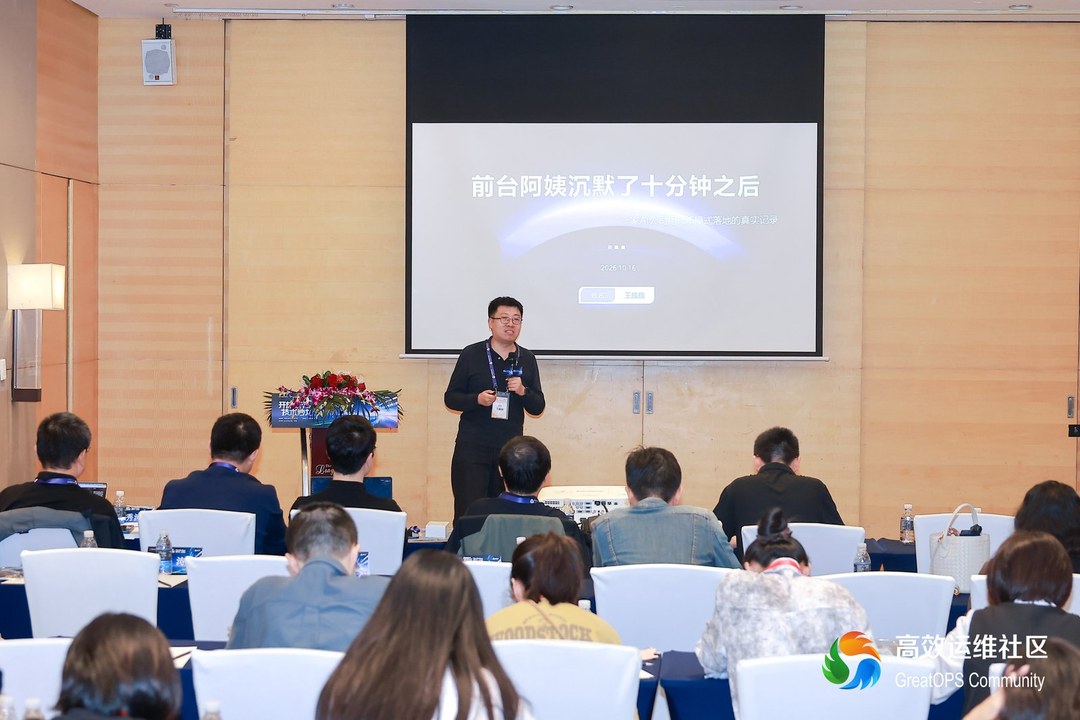
他的切入点是 FDE(Forward Deployed Engineer,前沿部署工程师):深入客户业务现场,与业务团队共同完成产品落地。在其团队的实践中,工作从观察前台操作、梳理客房流转和理解经营指标开始,再选择适合 AI 介入的环节,逐步完成验证与迭代。能否进入真实流程、让一线员工愿意使用,是交付的重要一环。
团队采用现场 FDE、业务陪跑与远程 AI 工程师协作的方式,一个小组覆盖 5~8 家区域酒店,远程工程师可跨组提供支持。在收费机制上,团队探索对超过约定营业额基线的增量部分按 20% 分成,按季度核验结算。按照分享中的示例,基线取前两年同期营业额中的较高值。这一模式也要求双方提前明确收入统计、核验与归因方式。
他还用一个前台场景解释如何开展 5 Why 根因分析:客人投诉入住等了 18 分钟,追问后发现房卡迟迟未能制作,原因是系统仍将房间标记为“脏房”;继续追问,才发现更新房态需要五步操作,一线员工常常跳过。改进由此落在流程与交互设计上。相应地,他看重 FDE 的流程梳理、根因分析和沟通能力,以及将业务问题转化为可执行工程任务的能力。
落地过程中的问题同样具体:高峰期模型响应慢,团队通过语义缓存和小模型前置改善体验;员工不愿分享操作过程,就先从能帮助其省事的小功能建立信任;OTA 接口接入受限时,先用人工对账衔接业务;提示词版本不一致,则通过 Git 与决策日志管理版本、保留可回放记录。对增量收入的核验,还需要结合 OTA 后台、酒店管理系统(PMS)与第三方支付流水交叉核对。
NUMA 架构下的数据库全栈调优
海光信息数据库技术专家李郭凯文以《NUMA 架构下的数据库全栈调优实践》展开分享,从硬件、操作系统、基础库与数据库内核多个层次,介绍多路服务器的性能分析与优化方法。
针对跨节点争用,他介绍了一套分层队列 NUMA 感知自旋锁优化方案:优先将锁交给本地节点的等待者,并在达到阈值或本地队列耗尽时进行跨节点交接,以减少缓存行的跨节点传输,同时避免节点饥饿。该方案尚未合入主线。配套的 NUMA 感知内存库则通过优化内存分配与回收的亲和性,减少远端内存访问。
数据库层面的优化同样需要结合具体负载验证。据其展示的测试结果,BOLT 优化使 MySQL 性能提升约 15%;缓存行对齐优化在不同线程数下使 TPS 提升约 1.94%~3.31%;关键函数强制内联在双路只读场景下带来约 5.43% 的提升。他还介绍了通过无锁哈希结构管理活跃事务、降低全局互斥锁竞争的方案,以及 PostgreSQL LWLock 加锁路径和关键并发参数的优化。对于基于 PostgreSQL 社区 AVX-512 CRC32C 优化实现的测试,多次 pgbench 测试取平均值后,性能提升约 3%~4%。
让智能诊断深入数据库源码
腾讯云数据库内核研发专家王嵩立带来《构建数据库 AI 专家——研发视角下的专家模型与智能诊断》。云数据库实例规模增长,疑难问题的现场信息却分散在管控、存储、网络和操作系统等多个层次,定位根因往往需要跨层取证。据其介绍,在所统计的场景中,86% 的疑难工单需要内核研发深入定位。团队尝试将大模型与领域知识、工具和诊断规划相结合,把资深研发的经验转化为可复用的系统能力。
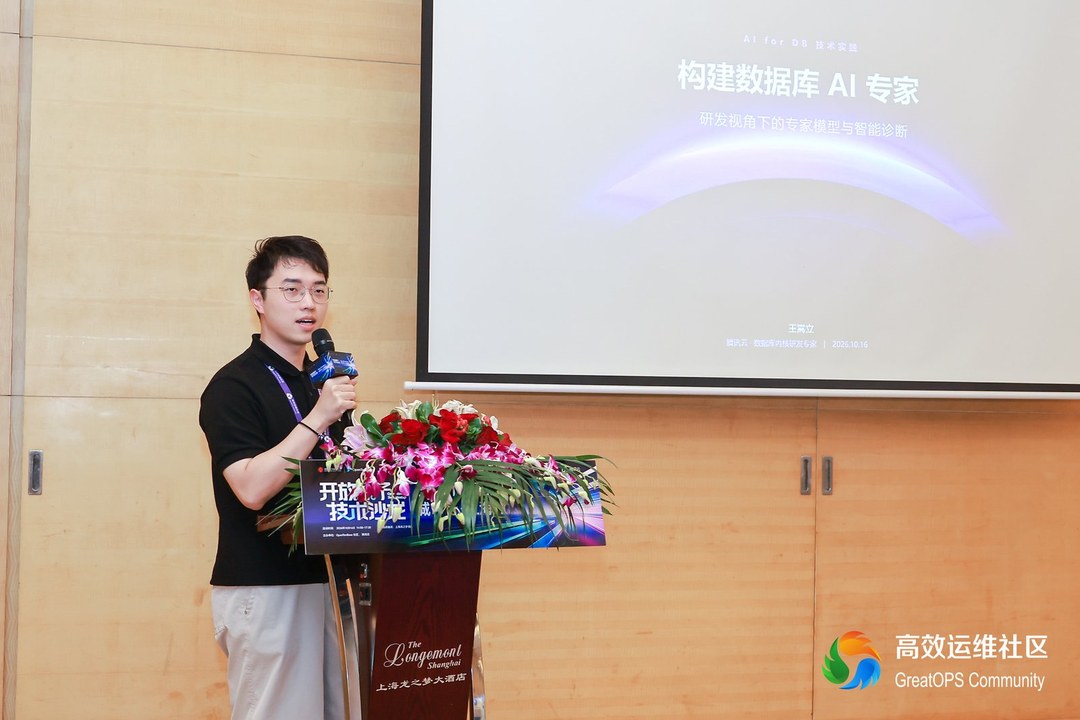
这套系统由知识底座、多层智能体、专家模型与诊断规划器共同支撑。知识底座整合设计文档、需求与缺陷记录、代码提交、社区问题与历史工单,积累了 13 万余条知识条目;源码按抽象语法树(AST)进行语义切片,支持从故障现象检索到相关代码。在展示的跨产品源码定位测试集中,Top10 命中率达到 96%,单次检索耗时为 8.2 秒。多层智能体按管控、内核、存储等职责分工,通过工具获取现场证据;专家模型学习真实工单中的专业判断;诊断规划器则协调排查顺序与工具调用。此外,团队通过本体建模关联研发过程资料,帮助系统在新特性尚未积累大量工单时获得诊断依据。
他结合真实工单评测与平台运行数据展示了应用效果:按分享中的统计口径,AI 有效解决率由约 20% 提升至约 81%,工单平均处理耗时由 3.29 小时降至 1.7 小时,AI 前置诊断约需 10 分钟,崩溃问题的平均解决时长由 23 小时降至 3 小时。分布式数据库产品接入后 4 个月,工单解决率达到约 72%,体现了跨产品复用诊断经验的价值。目前内部已有 200 多人使用,月均调用超过 450 次。
变化也体现在工单处理流程中:从人工全程排查,到 AI 辅助查找相似案例,再到诊断机器人前置取证、给出根因判断与证据链,研发人员逐步把精力集中在结论确认和复杂问题处理上。未解决工单则通过回顾与归类,继续用于改进模型、工具和案例库。
一个真实工单展示了跨层协作的必要性:业务出现大量连接失败,慢 SQL 突增,但负载没有明显变化,傍晚又自行恢复。管控层智能体发现,当天凌晨宿主机更新过存储访问客户端组件;内核层看到慢 SQL 堆积与连接数暴涨;存储层发现流控信号增多、读延迟上升。关联三层证据后,团队将问题定位到客户端组件更新引发的连接重建与读延迟上升,底层变化放大了原本效率偏低的 SQL。仅从 SQL 层观察,容易遗漏这一触发因素。
他将落地经验归纳为四点:从真实问题出发选择技术;建立能用真实工单验证效果的评估方法;明确人与 AI 的职责边界并保留人工接管机制;持续积累高质量的训练、评测与精标数据,让系统改进有据可依。
把智能体授权落到执行边界
最后一场主题分享来自 OpenTenBase ACE、独立开发者、“川序”智能体管理平台创始人尹海文。他以《使用数据库为底座实现智能体治理》为题,介绍数据库在身份、权限、状态与审计管理中的作用。
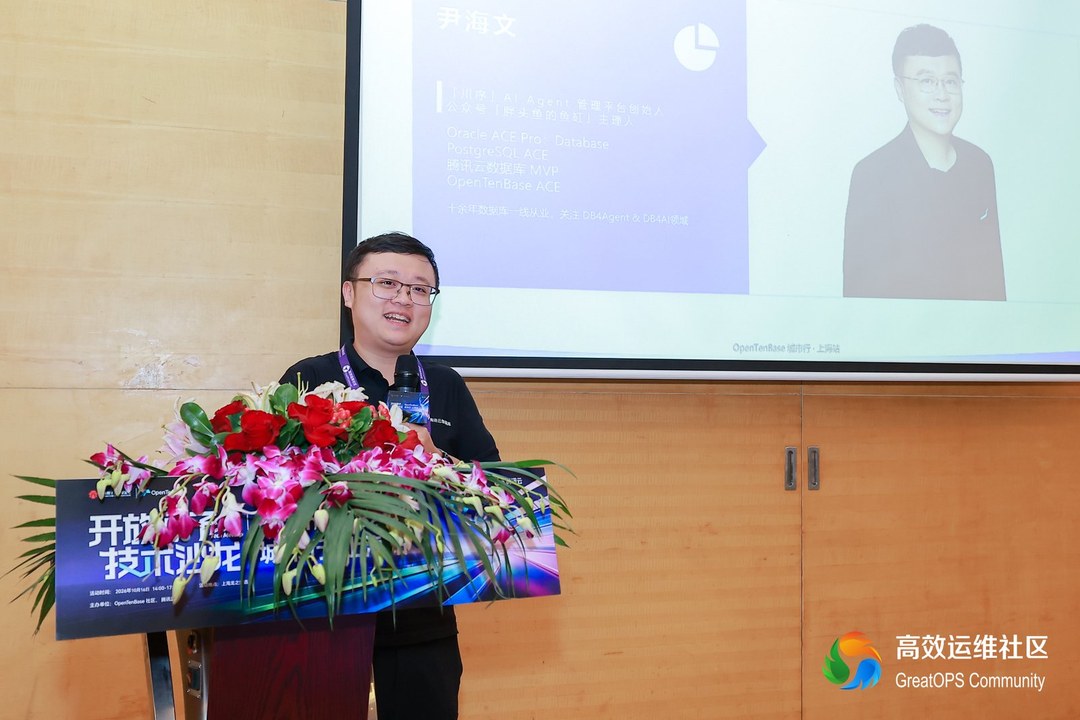
他先提出七个生产环境必须回答的问题:智能体代表谁运行?凭什么执行某个动作?当前应获得哪些上下文?进程中断后如何继续?谁批准了操作?Token 费用归属谁?出事后如何停止?这些问题需要明确的工程机制与责任边界。
结合团队的实践,他指出,仅依赖进程内状态而没有可靠的持久化机制,任务就难以在故障后恢复;只具备向量检索能力而没有权限校验,也无法保证知识访问安全。提示词可以引导模型行为,但授权必须在服务端与数据库访问边界强制执行。业务身份失效时,应拒绝继续访问,不能为了让任务跑完而回退到管理员连接。
“川序 Chuanxu”以数据库为统一控制面,将身份、上下文、知识、执行、授权、协作和运维七层能力串联起来。授权综合校验身份、角色与委派关系、组织范围、安全域、资源权限、任务用途和有效期;命中显式拒绝规则,或缺少必要授权信息时,默认拒绝执行。在知识检索中,该方案先按授权范围过滤候选内容,再进行检索排序,确保未授权内容不会进入模型上下文。
执行状态同样需要落库。任务运行前记录输入、责任主体与约束,运行中更新租约和检查点;进程中断后,新实例重新校验授权与租约,从持久化检查点恢复。方案的控制边界也很清楚:可以阻断后续访问、撤销凭据并隔离受管实例,但无法收回已经导出的数据,也无法直接停止未接入受控执行面的外部进程。
从运维角度看,数据库作为治理底座可以复用已有的备份、高可用与监控体系,将状态变更和审计记录放在同一事务中提交,利用 RLS 和 GRANT 等机制实施数据库访问控制,并通过 SQL 查询和报表支持排障与巡检。这些能力需要与服务端身份校验、运行时执行控制及人工审批配合,形成完整的治理流程。
他最后给出五个可验证的检查点:越权请求能否被拒绝,进程中断后能否恢复,调用责任能否追溯到人和组织,费用能否准确归属,以及撤销授权后后续访问能否失效。将这些能力逐项验证,是走向规模化运行的重要准备。
开源实践与社区参与
活动最后,王嵩立还带来了 TXSQL 开源实践分享,介绍数据库内核与开源社区的实践经验,帮助到场开发者进一步了解 TXSQL 项目的代码架构、贡献方式和参与路径。
从下午两点到五点,来自芯片厂商、云厂商、创业公司与开源社区的讲者,从不同角度讨论了 Agent 进入实际业务后的工程挑战:数据库如何适应新的访问模式,软硬件如何协同提升性能,故障如何更快定位,权限与责任如何落实,以及 AI 产品如何在客户现场创造价值。
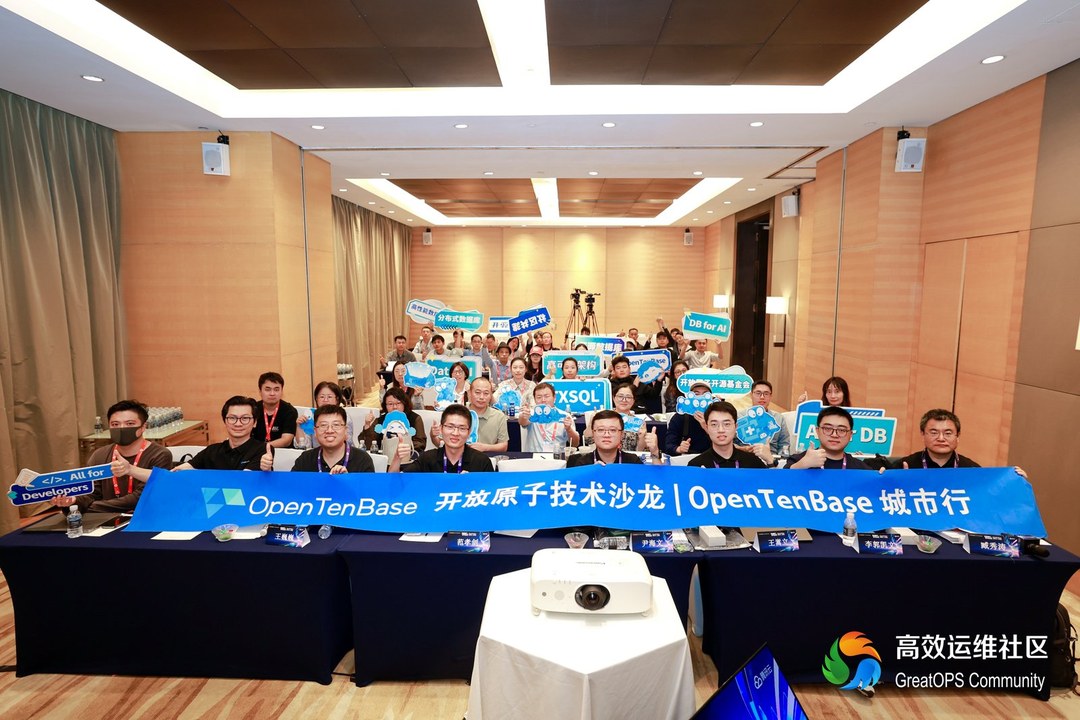
城市行还在继续。11 月7日,OpenTenBase 城市行将走进西安,敬请期待。
OpenAtom OpenTenBase 社区
开源分布式数据库 · 欢迎 Star 与共建